Token 經濟學 - 電報式提示詞
 |  | 1 |  |
6/1 起 Github Copilot 將全面改為以 Token 計費,GPT/Claude/Gemini 等各家各家模型紛紛緊縮 Token 額度或提高費率,恣意揮霍 Token 的時代已然結束...
LLM 大語言模型處理資料與生成內容的單位是 Token (延伸閱讀:文字轉 ChatGPT Token 之實驗與觀察、Go 小工具 - CLI 版 Token 計數器),除了與模型使用計費有關,也攸關 AI 生成結果的品質。LLM 模型有所謂的上下文窗口 (Context Window),不同模型上限各異:
| 模型系列 | 最大上下文窗口 (Tokens) | 最大輸出 (Tokens) |
|---|---|---|
| GPT-5.4 / 5.4-pro | 1M | 128K |
| GPT-5.4-mini / nano | 400K (輸入上限 272K) | 128K |
| GPT-4.1 | 1KK | 128K |
| Claude Sonnet 4.6 / Opus 4.6 | 1KK | 128K |
| o3 / o4-mini | 200K | 128K |
| GPT-4o | 128K | 4,096 |
| DeepSeek-R1 | 128K | 32,768 |
| Mistral Large 2 | 128K | 128K |
雖然各家新一代模型的上下文窗口長度不斷突破,已可達到 1M 的水準,但過長易導致注意力稀釋以及幻覺問題,可能導致模型出現重複字詞、語意不連貫或邏輯混亂等「上下文腐化(Context Rot)」現象。總而言之,能實現相同結果,使用的 Token 數愈少不但能節省成本,生成品質也會更好。
回到 AI Coding 上,我們在 Github Copilot / Claude / Codex 聊天視窗輸入提示詞時,也適用這個原則。如何用更少的 Token 精準有效地表達我們的意圖,獲得預期結果,是講求 Token 經濟學的新時代的新課題。(什麼?你有十個 MAX 訂閱,沒操心過 Token 額度?咳,以您的模力值不必跟我們研究這些,全程放大絕就可以囉)
總之,我花了點時間查了資料,研究讓 AI 提示詞「一字千金」的小技巧。
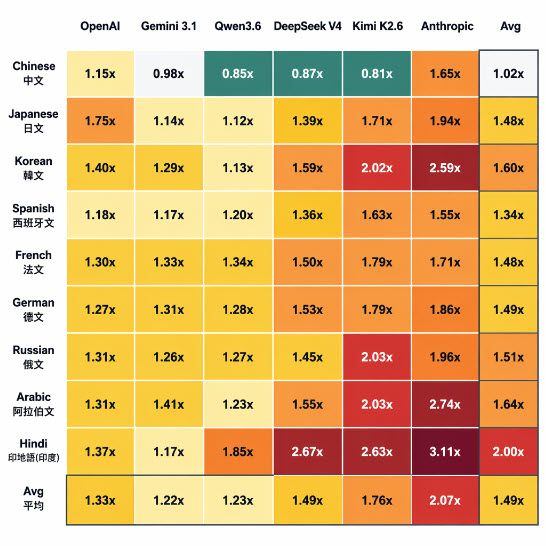
首先,依「語言稅」理論,使用中文在 GPT、Claude、Gemini 等模型上會比英文耗用更多 Token ,因此除非是用 Qwen、DeepSeek、Kimi 等中文模型,直接用英文寫提示詞是更好的選擇。
再來,前陣子有個可安裝在 Codex、Gemini、Cursor、Windsurf、Copilot 的山頂洞人(Caveman) Skill 受到觀注(Github 專案已 6.4 萬顆星星),號稱可以節省 75% Token,做法超級簡單,在 SKILL.md 中要求 Agent 像原始人一樣說話,移除冠詞、填充詞、客套話... 但完整保留術語關鍵字,程式碼區塊等,藉此讓模型的輸出變得簡短、無廢話。
而同樣概念應用在下提示詞,則有種相關概念的做法 - 用打電報的方式下提示詞。電話還沒出現的古老年代,遠距即時通訊只能靠摩斯電碼傳送電報文字,以字數與距離收費,故發訊息的人必須絞盡腦汁,用最少字數表達意思,跟現在壓低 Token 數以降低成本提升品質異曲同工。
Telegraphic Prompting 技巧 (電報式提示,有時也稱為 Prompt Compression 或 Token Optimization) 是指刪除提示詞中的助動詞、冠詞、標點符號或多餘客套話,僅保留核心意義的關鍵字,像發電報一樣簡潔。如:Refactor: improve readability, O(n) complexity, TypeScript. 這樣就夠了。電報風格不用管主副詞介係詞,不必花時間把組成文法正確、辭藻優美的句子,除了減少 Token 量還能節省大腦,但我覺得寫久了,英文寫與說的能力會退化就是了 😄
以下是我找到一些寫電報式提示的零碎技巧:(我的日常應用以 AI Coding 為大宗,故技巧會偏程式一些,但有些在非程式情境也適用)
別說請謝謝對不起,交待 AI 任務禮貌是多餘的
有研究提示的 26 提示詞原則中的第一條原則便是「不需要對 LLM 保持禮貌 (如說 Please, Thank you),直接講重點」,實驗證明,過多的社交辭令不僅浪費 Token,有時反而會干擾 AI 對核心指令的注意力。
❌ Could you please write a Python function to sort a list?
✅ Write Python list sort function.
定義角色取代長串定義描述
直接指定 AI 扮演角色(如:Act as a senior Go Dev.)跟 I want you to act as a senior software engineer specialized in Google's Go programming language 效果相近,但可省下 80% Token。
限制無效輸出
AI 很能聊,答案之外常會補充解釋說明,分享心路歷程,若我們只要結果,這些額外內容全是多餘的,且會浪費寶貴輸出 Token (輸出 Token 通常比輸入貴好幾倍)。有一些常用的簡寫可以有效阻止 AI 模型錦上添花畫蛇添足:
Code only./Pure code.給我程式,其餘免談No prose.prose 是散文的意思,指說重點別寫作文No preamble.preamble 指前言或開場白No postamble.去掉程式碼後面的總結與提醒No yapping.別廢話。超兇! 我喜歡No comments.不用註解Self-documenting code only.要求程式碼本身清晰易讀,減少對註解的依賴Docstring only.只生成標準的函式文件註釋 (如 Javadoc, TSDoc, PyDoc),不要解釋邏輯Bullet points.解釋時使用條列式,不要寫大段文字
言簡意賅的約束指令
希望生成內容或程式碼簡潔、正統,有一些好用的約束詞:
Concise.力求簡潔Idiomatic.使用符合最佳實踐、哲學與設計模式的寫法Explain briefly.簡短解釋- `Dry. (Don't Repeat Yourself) 避免重複邏輯,提取公用函式
Solid.遵循 SOLID 原則,寫出易於維護與擴展的物件導向程式Clean.要求符合「Clean Code」原則,注重變數命名與邏輯清晰度Production-ready.要求考慮生產環境所需細節(如錯誤處理、日誌、穩定性)Modern.使用該語言最新的語法特性(例如 Python 3.12+, Java 21+, ES6+)Standard lib only.禁止使用第三方程式庫,只使用語言內建 APIPerformant.效能優先,減少不必要的資源消耗Memory-efficient.記憶體效率優先,避免記憶體洩漏或過度分配O(n)./O(1).指定時間複雜度上限Thread-safe.` 要求注意多執行緒環境的 Race Condition 問題Scalable.要求架構要考慮到未來擴展性Step-by-step.要求循序漸進拆解,方便理解學習One-liner.將邏輯寫成單行(常見於 Bash 指令或簡單的 Python 邏輯)- ‵1-sentence summary` 一句話總結
Raw.回傳原始格式,不需 Markdown 標籤Diff.傳回像 Git 一樣的差異對照Naive implementation.只需要最簡單、不考慮優化的雛型,不要過度設計Sanitized.特別指處理輸入防止 SQL Injection、XSS 等攻擊Hardened.加強抗攻擊與安全防護- ‵Graceful degradation.` 某些功能失敗時,系統仍能以有限功能運作
Skeleton only.只生成類別與函式的定義,只做骨架不要實作細節
指定輸出格式
若需要特定格式(如 JSON, Diff),直說即可,如:Output: pure JSON., Format: git diff.。
提供程式片段即可
若想跟模型交待要處理的部分,不用貼上全部內容,提供相關函式或類別定義就好了,必要時可用 //... 表示省略不相關部分。
善用 Markdown 等結構化表示
使用 # ## 區分章節,用 ```...``` 、"""...""" 包夾區塊內容,用 `code...`、<code...> 標示指令,能讓模型快速且有效率地理解你的意圖。
範例
以下是一些高效提示詞範例:
- 重構程式碼:
Refactor for performance: {code} - 撰寫測試:
Write xunit tests. Focus on edge cases. Code only. - 除錯:
Debug: {error message}. Fix and explain briefly. - 轉換語言:
Convert this Python to Rust. Idiomatic. - 生成文檔:
Generate TSDoc for this function. Concise. - 程式碼審查:
Code review. List 3 critical improvements.
應用上,想成跟 AI 用黑話或行話溝通就對了,像生活中的"北車南三,七點"、","top tp 30, play safe"、"大奶微微"... 我們可能做出這樣的例子。 Refactor this. Clean. Dry. Modern. Code only.、Explain this. Bullet points. 1-sentence summary. No yapping.
另外有個小技巧是這些執行要點建議可放在提示詢結尾,因為模型對最後一段的注意力通常較長 (Recency Bias)。
效益考證
關於電報式提示詞,我有找到幾年前的相關研究,但沒有針對最新模型的權威性實證或心得分享:
- Bliss, Bag of Words, and Telegraphic Prompting of LLMs
Bag of Words提示法,僅提供少量關鍵詞給 LLM,再由模型生成完整句子 - 微軟研究的 Prompt 壓縮演算法 LLMLingua
使用便宜模型壓縮長篇提示,結果為精簡文字,但不到電報程度 - 論文:An Empirical Study on Prompt Compression for Large Language Models
提示壓縮不僅能降低成本,還可能在長上下文中提升效能,但可能帶來幻覺風險 - 論文:Unlocking Context Constraints of LLMs: Enhancing Context Efficiency of LLMs with Self-Information-Based Content Filtering
移除冗餘內容後,模型在總結與問答任務中的表現並未顯著衰減
雖然沒有鐵證支持,簡單測試,改用電報文確實石達成相同效果,而其運作原理合情合理,直覺會是有效的。而研究到後來,感覺節省 Token 之外,濃縮精簡輸入文字的更大好處是可降低打字成本,加快輸入速度,效益更明顯。總之,我決定開始在日常 AI Coding 試行看看,過陣子再來分享實戰心得。
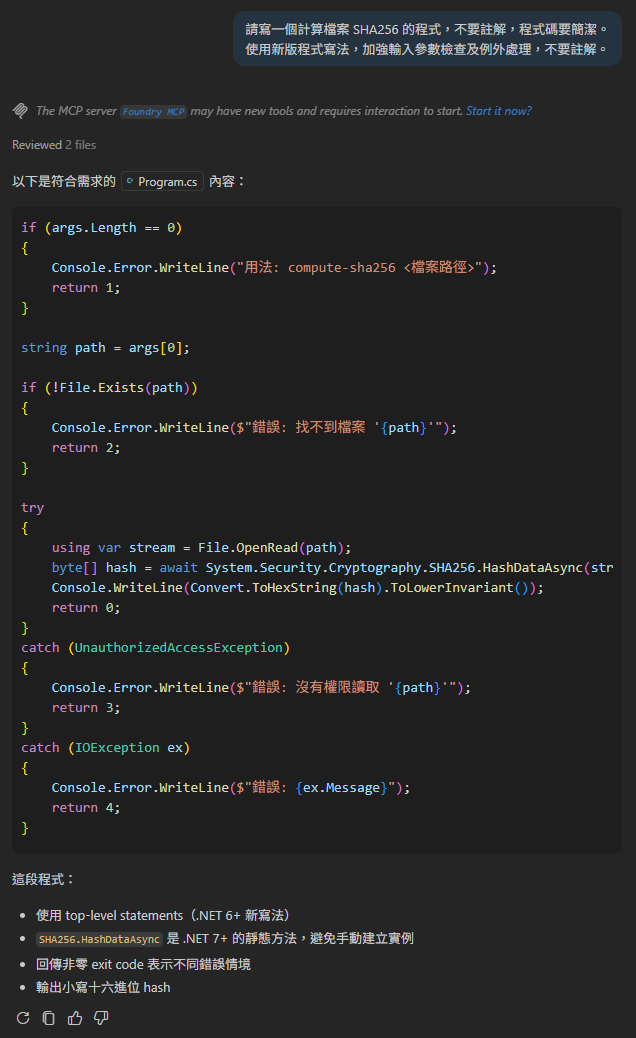
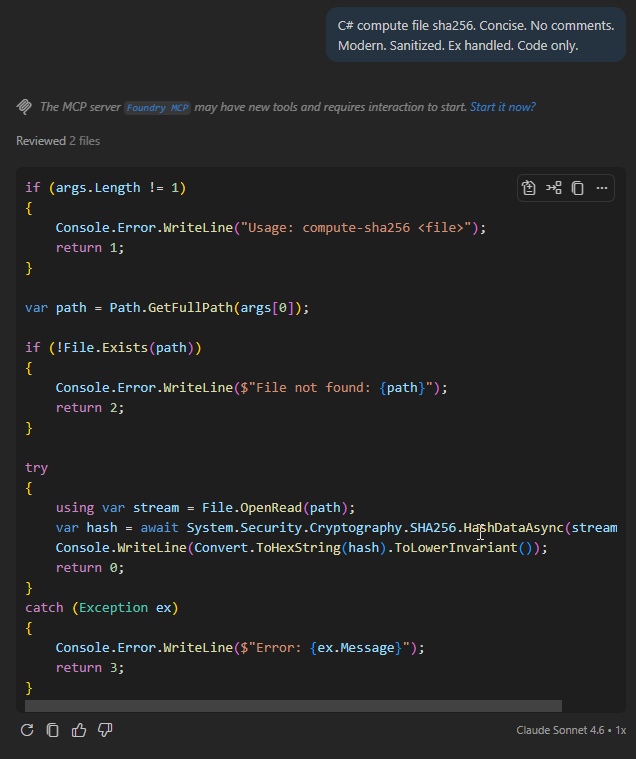
【後記】最近在做一個串接 GPT 模型的 Windows 語音輸入法 Side Project,概念是把先前 GPT 模型口語轉譯服務改裝為作業系統可用的輸入法,「整合電報式提示哲學,將口述中文轉成英語電報文」感覺有點搞頭,就來試試。
Explores token-efficient AI prompting for coding, explaining rising token costs, context limits, “language tax,” caveman style, and telegraphic prompts. Shares practical techniques to reduce input/output tokens while keeping prompts precise, structured, and effective.
Comments
# by wellxion
我一直以來都是用這種方式調用AI,效果還比較穩定,不過長時間互動還是會有逐漸忘記束縛的情況。 除非是你想玩情境互動,不然我一直不懂為何大家都喜歡對AI加入情緒溝通。