網際網路世界的時光機 - Wayback Machine
 |  | 0 |  |
想重現「某年某月某一天,某個網站當時顯示的內容」,有可能嗎?
感謝 Internet Archive (網際網路檔案室),如果網站夠熱門,還真有台時光機能讓你回到當年,重現當時的畫面。
Internet Archive 是全球最大的數位圖書館,其使命在於保存網際網路的歷史記錄,見證人類文明發展 😄。
其運作原理是每天透過自家的「Heritrix 網路爬蟲」在網路遊走收集網頁內容,由一組種子網址(Seeds)出發,抓取該頁面的 HTML 並自動尋找頁面的所有超連結,再延伸到整個網站及其他網域,最終爬完幾乎整個 Internet 的內容(使用者也可以手動輸入網址立即對特定網頁進行快照保存)。
抓取下來的網頁並非簡單的圖片或 HTML 檔案而已,它會以國際標準 WARC (Web ARChive) 格式封裝。WARC 檔案包含原始的 HTTP 回應(HTML、CSS、JavaScript、圖片、影片等)以及 HTTP Header(伺服器回傳的元數據,如網頁最後修改時間、編碼格式等),系統則會計算檔案的 SHA1/SHA256 雜湊,確保重複資料只會保存一份避免浪費空間,並改寫 HTML 中的連結,將 <img src="/logo.png"> 改成 <img src="/web/20200101000000im_/https://example.com/logo.png"> 使其指向快照版本。
即便已將重複內容歸納成一份,整個 Internet 內容每天不斷更新,要保存的資料量仍十分驚人,Internet Archive 是將數以 PB 計的資料儲存在位於舊金山及全球各地的數千台伺服器中。
而這些資料最神奇的應用,便是其提供的網頁時光機 - Wayback Machine。
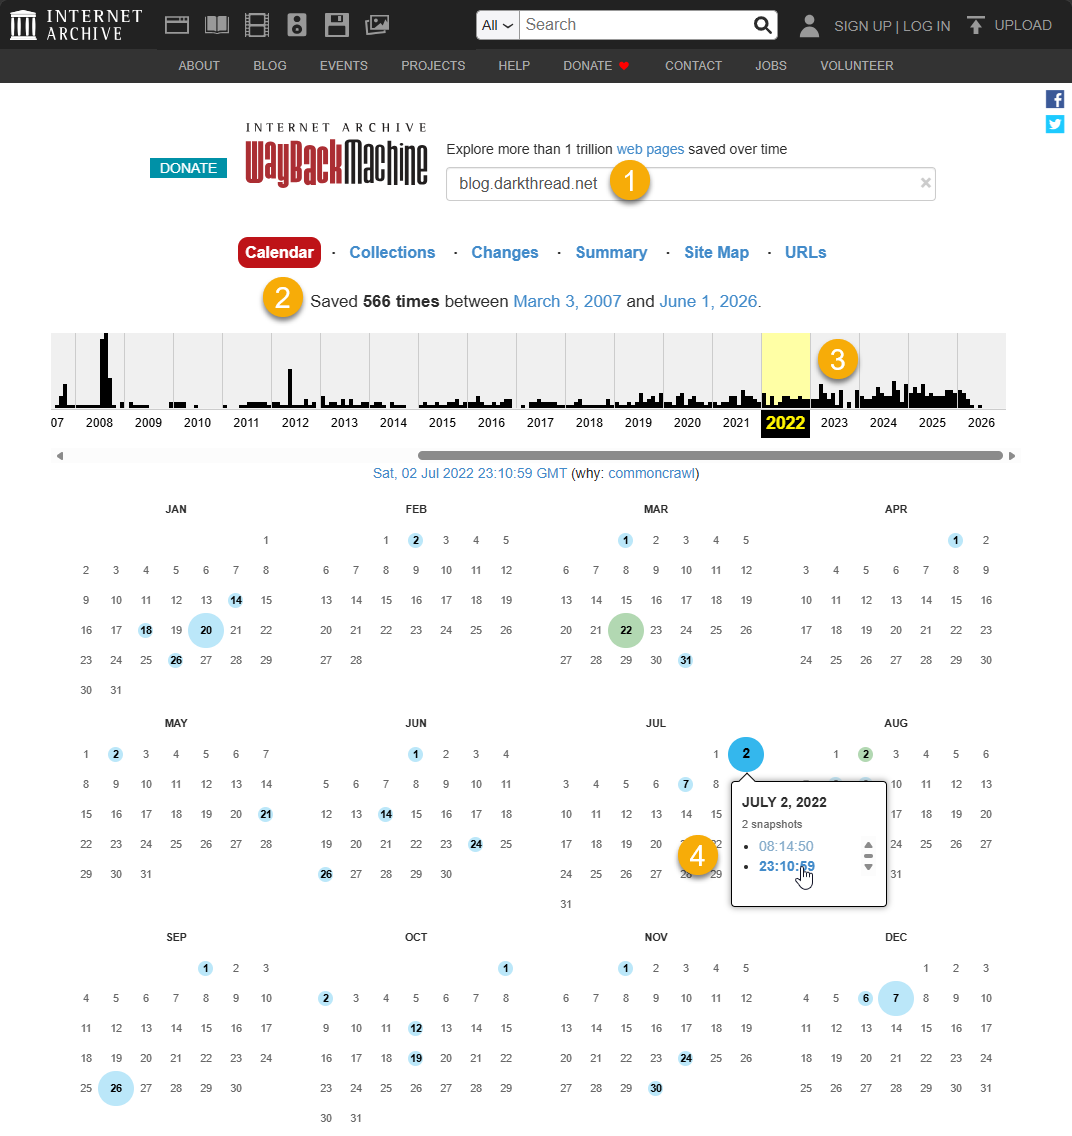
如下圖,輸入網址 [1] 可查到 Internet Archive 所收藏該網址的所有快照 [2],另外有時間軸呈現快照的保存時間點 [3],最下方為以年為單位的日曆,藍色圓圈為有保存快照的日期 (圓圈愈大表示快照數量愈多),滑到該日期會顯示快照時點清單 [4],點下去便可開啟快照回到過去:
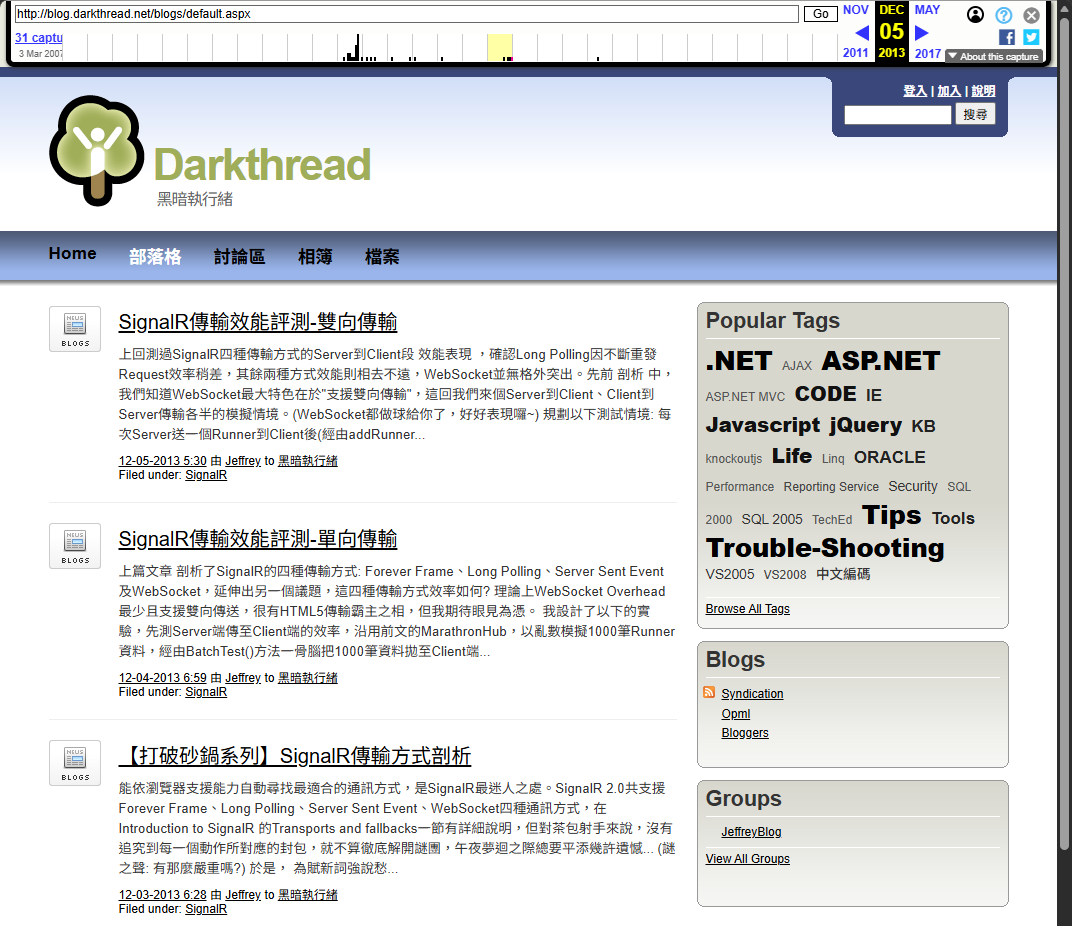
下圖是 2008 年我的部落格從 Google Blogger 搬到自建網站初期的模樣 (Community Server + SQL Server):
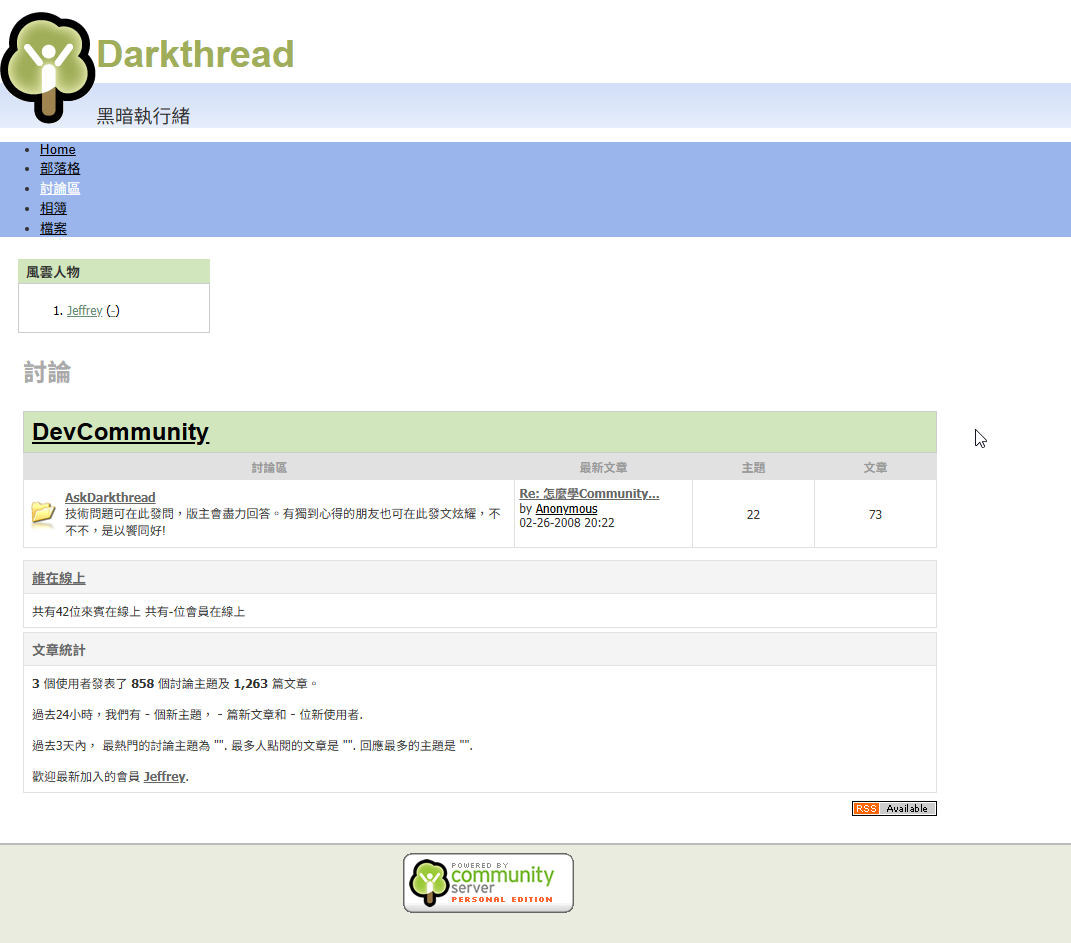
當時網站除了部落格還有討論區,Community 伺服器早已下線,資料庫也刪了,這是唯一能重現懷舊時光的方法。
有些快照網站點連結甚至可以查看當時該網址的內容。不過,網頁快照可能因 JavaScript 動態產生、爬蟲抓取錯誤或爬取不完整等因素,不是所有快照網頁都成功還原;也有些內容會被排除,像是我想找魔鏡歌詞網,會得到 This URL has been excluded from the Wayback Machine.。
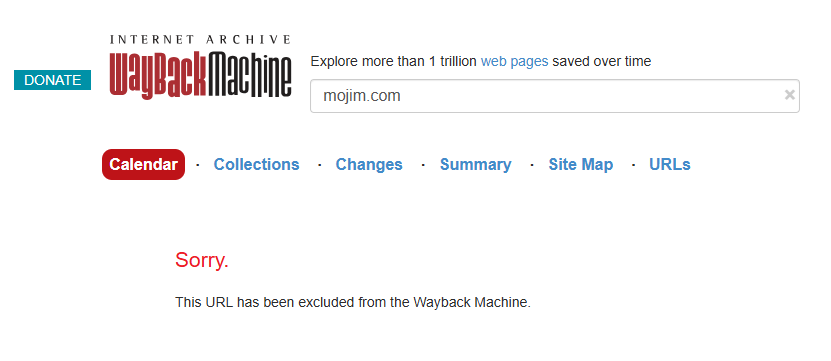
被排除的原因有可能是網站 robots.txt 禁止爬取、網站所有人因隱私或版權要求排除 (魔鏡歌詞網應是版權考量),一旦被要求排除,網站的所有快照都會被清空。
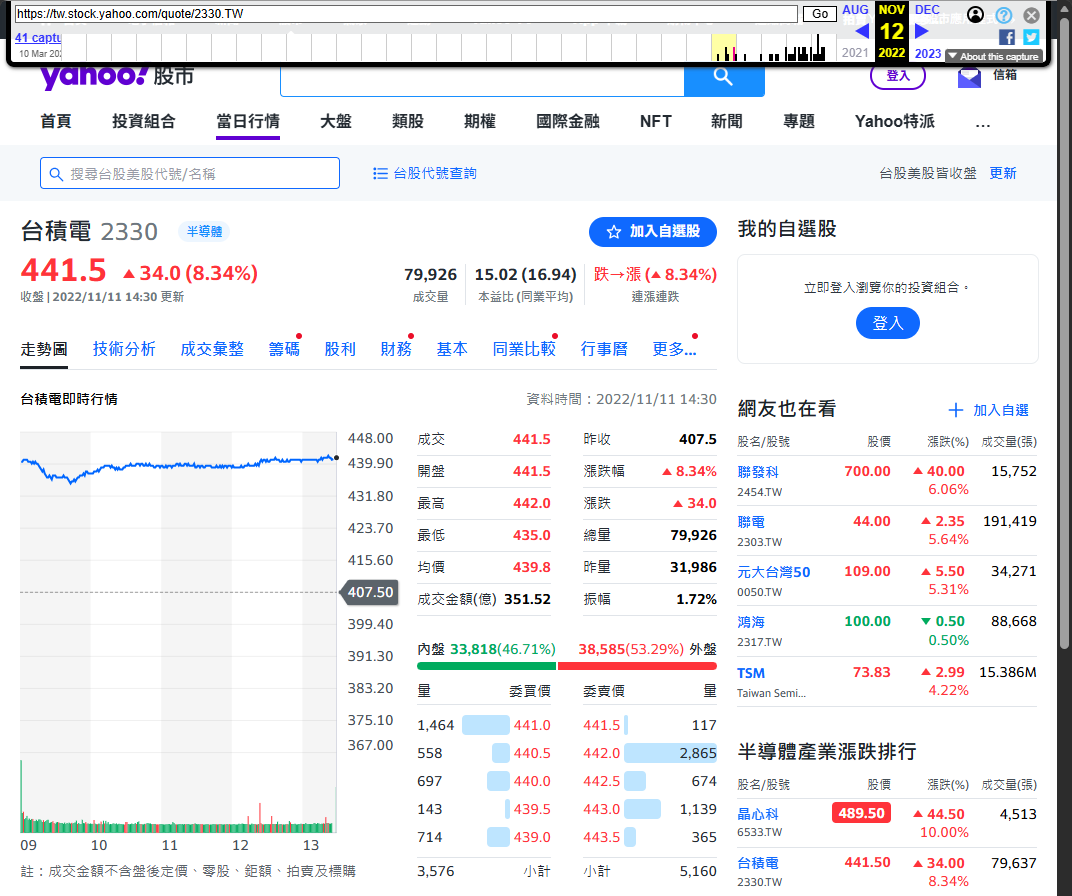
最後,用這張 2022 年 ChatGPT 3.5 發佈前 20 天,AI 大爆發前夕的台積電股價當做結尾。(如果買股票也能坐時光機下單就好了...)
【後記】看到自己的網站歷史被保存下來有點小感動,順手添了點香油錢... (大家也可以隨喜支持一下,讓這個佛心服務長久營運下去)
Comments
Be the first to post a comment