YT 筆記 - AI 科普 / NLP 自然語言處理簡史
 |  | 0 |  |
在 YouTube 滑到 NLP 發展史影片,挺淺顯易懂,感覺可當做 AI 科普,了解這一路 NLP 領域如何演進,電腦發展到能博覽群書、妙筆生花?花了時間整理筆記,順手分享。
NLP Natural Language Processing 自然語言處理,是指讓電腦能處理人類的自然語言(相對於電腦已經擅長的程式語言),具備理解文字、聽懂說話以及寫作的能力。早從 1940 年計算機被發明不久,科學家便在這個領域開始努力,而 NLP 的發展大致可分為四個階段。
基於規則的手工學習階段
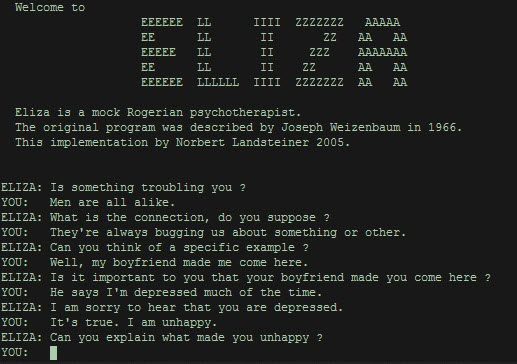
在計算機誕生初期,學者們就野心勃勃想讓程式能理解人類的語言。當時的想法很單純,人類是怎麼學習語言,電腦照著做就好。記住單詞,學會語法。 但這個路線發展了 20 年,最終受挫於複雜度的高牆,寫好幾萬條語法規則才可以大概覆蓋 20% 語句,語言學家根本沒有辦法寫出這麼多規則,而且當規則多了後還會前後矛盾,為了解決矛盾,還要限定規則的特定使用環境。1966 年,在耗資 2000 萬美元卻沒有任何成果後,美國國家研究委員會停止對 NLP 相關項目的資金支持,NLP 發展陷入停滯。唯一的標誌性事件,是它誕生了歷史上第一個自然語言對話程式 ELIZA,但它只能遵循簡單語法規則和人進行非常淺顯的對談,離人工智慧有極大的差距。
基於統計的機器學習階段
1972 年,賈里尼克教授加入 IBM 華生實驗室負責語音識別,提出一個新觀點:用機率與統計的角度去判斷句子的合理性,例如:Wow Shi Huan Ni 的發音,是「我喜歡你」的機率遠大於「我洗換泥」,故它更可能是正確答案。他利用一種數學方法來計算出句子出現的機率,比如「我喜歡你」這句話出現的機率,是「我」出現的機率,乘以第一個詞是「我」第二個詞是「喜歡」的條件機率,再乘以第三個詞是「你」的條件機率,這就是所謂的 N-gram。
如此不需要統計所有人說過的所有話,只需統計一個樣本(語料庫)就可以,但樣本數要夠大,統計出來的機率才會接近真實情況。
利用這種基統計的做法,賈里尼克教授把語音識別準確率從 70% 提升到 90%,而這個處理語音識別的方法也可以應用在整個 NLP 領域。例如要判斷郵件是否是垃圾郵件,可以統計各個詞出現頻率來預測是或否,成為標準的監督學習案例。這個流派本質是統計學和機器學習的結合。
基於統計學和機器學習的做法受到規則派的無情的攻擊,認為基於統計的做法只能解決一些淺層的問題,無法再深入發展。(賈里尼非常地討厭語言學家,曾說過「每當我解僱一名語言學家,語音識別器的性能都會提高。」) 歷經 20 年爭論,直到上個世紀末,大家才開始認可基於統計學和機器學習的做法可能才是正確的方向。原因是電腦性能不斷提升,有能力完成很多過去不可能的任務;另一方面也是老一輩的反對派學者們都退休且後繼無人,研究經費漸漸轉向新方法。
統計派有很長一段時間成為主流,但仍存在缺陷,比如說稀疏數據 (一千個詞用一千個數字的陣列統計出現次數,大部分都是 0)、忽視單詞間的聯繫(例說 King 和 Lord,意義相近,統計時二者毫無關係)、字詞出現次數無法判斷語意相似度(例如:「我在追一隻狗」和「一隻狗在追我」,字詞頻率相同意思相反。
基於 Embedding 的深度學習階段
1943 年兩位數學家搭建了第一個神經網路;1958 年,一種叫感知機的模型被發明,它具備輸入層、輸出層和隱藏層,是當今人工神經網路的前身。後來出現了深度神經網路,神經網路這個領域開始飛速發展。 80 年代賈里尼克教授剛剛基於統計的方法時,神經網路派已悄悄發展。當時 RNN (Recurrent Neural Network)、LSTM (長短期記憶模型) 陸續出現。
一般神經網路的訊息為單向流動,從輸入層到第一個隱藏層,然後輸出層,其問題就在沒有記憶,不知道之前的輸入。RNN 加入循環讓模型有了記憶,能記住之前的單詞。到 2003 年時,用 RNN 處理自然語言已成 NLP 主流。約書亞 (Yoshua Bengio) 提出一個新方法,用神經網路的方法來計算文本的數學表示。
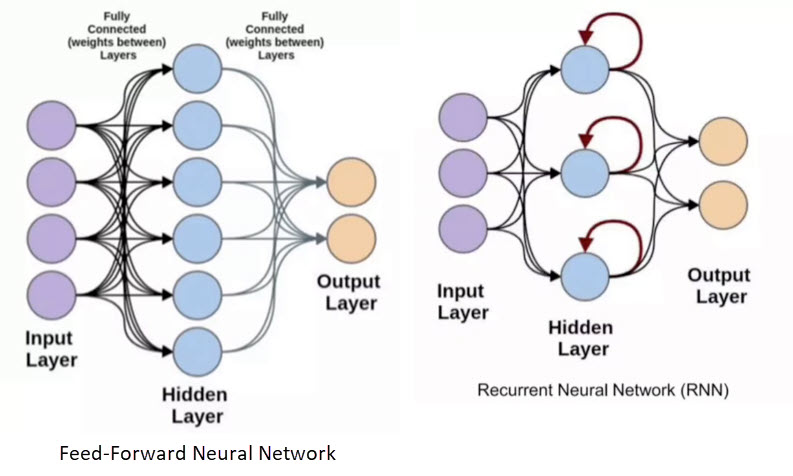
他用一個普通單向神經網路(也稱前饋神經網路)計算文本的數學值,稱之為 Embedding。Embedding 直翻為「嵌入」,可簡單理解為一組組神奇數字,這些數字能捕捉單詞和句子的語意。比如說「幽默」、「智慧」、「微笑」這些單詞的數值會比較接近;而「令人不安」、「黑暗」、「沉重」這些詞的數字則彼此較近;兩組詞之間間隔則比較遠。
真實情況下的 Embedding 是好幾百維甚至上千維的向量,它解決了之前說的幾個問題:第一是能捕捉句子和單詞的含義;再者是改善了數據稀疏性(十萬個單詞語料庫,不需要用十萬個 0101 表示,用幾百個數字就夠)。要計算 Embedding,做法是在計算神經網路過程將 Embedding 矩陣也當成神經網路的一組參數和其他的參數一起優化,。
約書亞 2003 年提出 Embedding 方法後,有許多人跟進,真正的突破點出現 2013 年 Google 發布了 Word2Vec,徹底地改變遊戲規則。一年後史丹佛發布了 GloVe,就是 Global Vectors;再一年後 Facebook 發布了 fastText。2013 年是分水嶺,在此之前就基於統計的 NLP 方法,之後呢在科技行業被逐步淘汰。現在的大廠或研究機構基本上都是基於 Embedding 方法。
Embedding 出現以後,NLP 領域開始加速狂飆。第二個突破是編碼器-解碼器 (Encoder-Decoder) 架構,其早在 1997 年就已有人提出,但真正的突破在 2013 年(Embedding 的同一年)。編碼器-解碼器架構是先把文本轉成數字表示(所謂編碼),再把這個數字用另一種方法再轉換成文本(所謂解碼)。像是在翻譯一句話,先把這句話的中文翻譯成數字,保留數字的義不變,再用另一種解碼方式把數字變成英文,讓這兩句話的意思一致,Embedding 讓編碼與解碼中間的數字有意義,能拓展到其他應用領域。
第三個突破是 2014 年 Seq2Seq 模型的出現。在這之前呢,NLP 大多是輸入文本,輸出一個固定的詞組或者數字。比如判斷一句話的情感是正面還是負面,或是給 Email 內容判斷是否為垃圾郵件(0 或 1)。序列到序列模型則是給一句話,回應一句話,如翻譯、提問與回答。
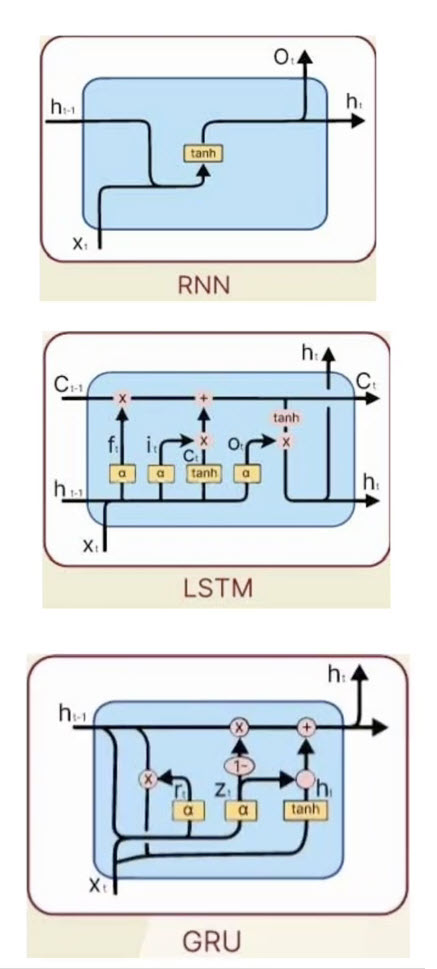
序列到序列模型算是編碼器-解碼器架構的變種,將其中的神經網路換成 RNN。RNN 有個問題是它只有短期記憶沒有長期記憶,LSTM 長短期記憶模型的出現便是為了解決長期記憶問題。和 RNN 相比,LSTM 的循環有短期及長期兩條循環管道,能較好保存長期記憶。LSTM 還有一個變種就是 GRU (門控循環單元),其將短期記憶和長期記憶合併簡化模型。
第四個突破是 2014 年,在編碼器-解碼器架構面加入了注意力機制。注意力機制會在傳送最終狀態外也會加上中間狀態,指示數據和輸入文本的相關性,讓跟句子更相關或更重要的詞得到更多的注意力。
第五個突破是 2017 年 Google 發布的論文《Attention Is All You Need》,正式宣告 Transformer 模型的誕生,成為當今所有 LLM 模型的基礎。
Transformer 是一個使用注意力機制的特殊編碼器-解碼器架構。它將多個相同結構的編碼器串聯在一起,每個編碼器從之前的編碼器裡面接收訊息,處理完再傳給下一個,解碼器也是如此。 相較於 RNN,Transformer 提出不用循環結構記住上下文的做法:用一個單詞 Embedding 來記住單詞,再用一個位置的 Encoding 記住單詞的位置,藉此實現可平行運算。
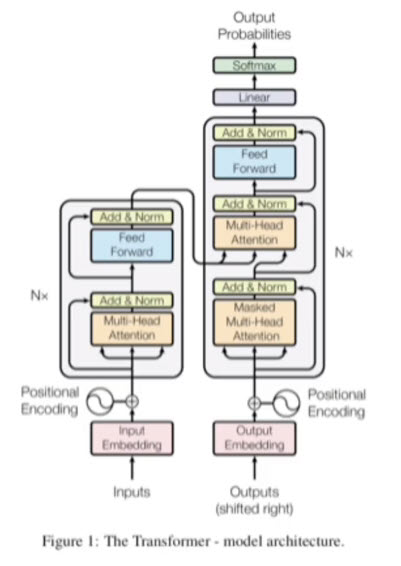
Transformer 的第二個特點是發明了自注意力機制 (Self-Attention),能計算出每個單詞跟其他單詞之間的關聯,發現某個詞與某個詞關聯特別緊密,其做法為通過三個矩陣,Query、Key 和 Value 矩陣來計算。模型用了多個注意力矩陣,而非單一注意力矩陣,實現多頭注意力 (Multi-Head Attention)。
Transformer 的出現使並行計算成為可能,引進大規模的計算讓 NLP 領域迎來爆發成長。2017 年出現 Transformer,2018 年 LLM 發展開始起飛。
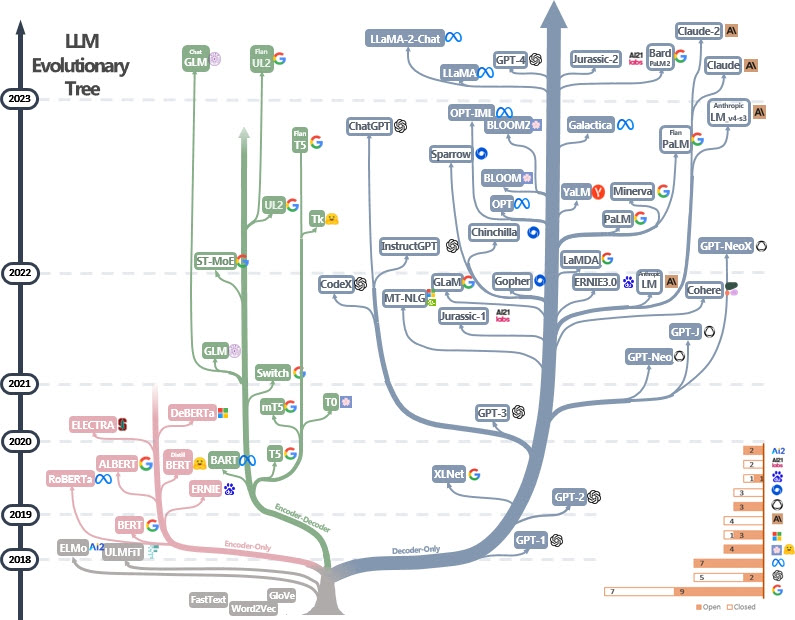
2018 年到 2019 年是 Google BERT 家族茁壯成長的一年,BERT 模型,BERT 基於 Transformer 雙向編碼器表示法,是當時最強的模型。雙向是指 BERT 同時考慮從左到右和從右到左來讀文本,藉以掌握上下文。因為 BERT 的訓練目標之一是遮擋掉一些詞,用模型預測說被遮擋掉的詞是什麼,知道上下文能更精準預測可填入的詞。而 BERT 只有編碼器沒有解碼器,。因為主要目標是理解文本。雖然 Fine-Tune 後也可做問答,但效果沒有後來的模型好。
BERT 的統治地位只維持一年,2019 年底呢,Google 推出另一個模型 T5 (Text-to-Text Transfer Transformer) Model,是一個 Encoder-Decoder 的架構。BERT 只能用於多個 NLP 相關任務,而 T5 幾乎可以用於所有跟 NLP 有關的任務,不管是翻譯還是總結,都表現得相當好,提供了一個通用框架,意味著可以用同一個模型、同一組參數來處理解決所有 NLP 相關的任務。
LLM 大語言模型階段
一年以後 2020 年 GPT-3 誕生,45 TB 數據、1700 億參數,是當時有史以來最大的預訓練模型,在業界引起轟動,之後各家卯足了勁砸錢做 Decoder-Only 模型,這個分支的模型呢就開始成長起來了。之後 2022 年 ChatGPT 橫空出世,接下來發生什麼事大家都知道了,LLM 全面掀起 AI 熱潮...
影片裡附的 LLM 發展樹只到 2023,如今的模型百花齊放,早已不可能塞入一張圖中...
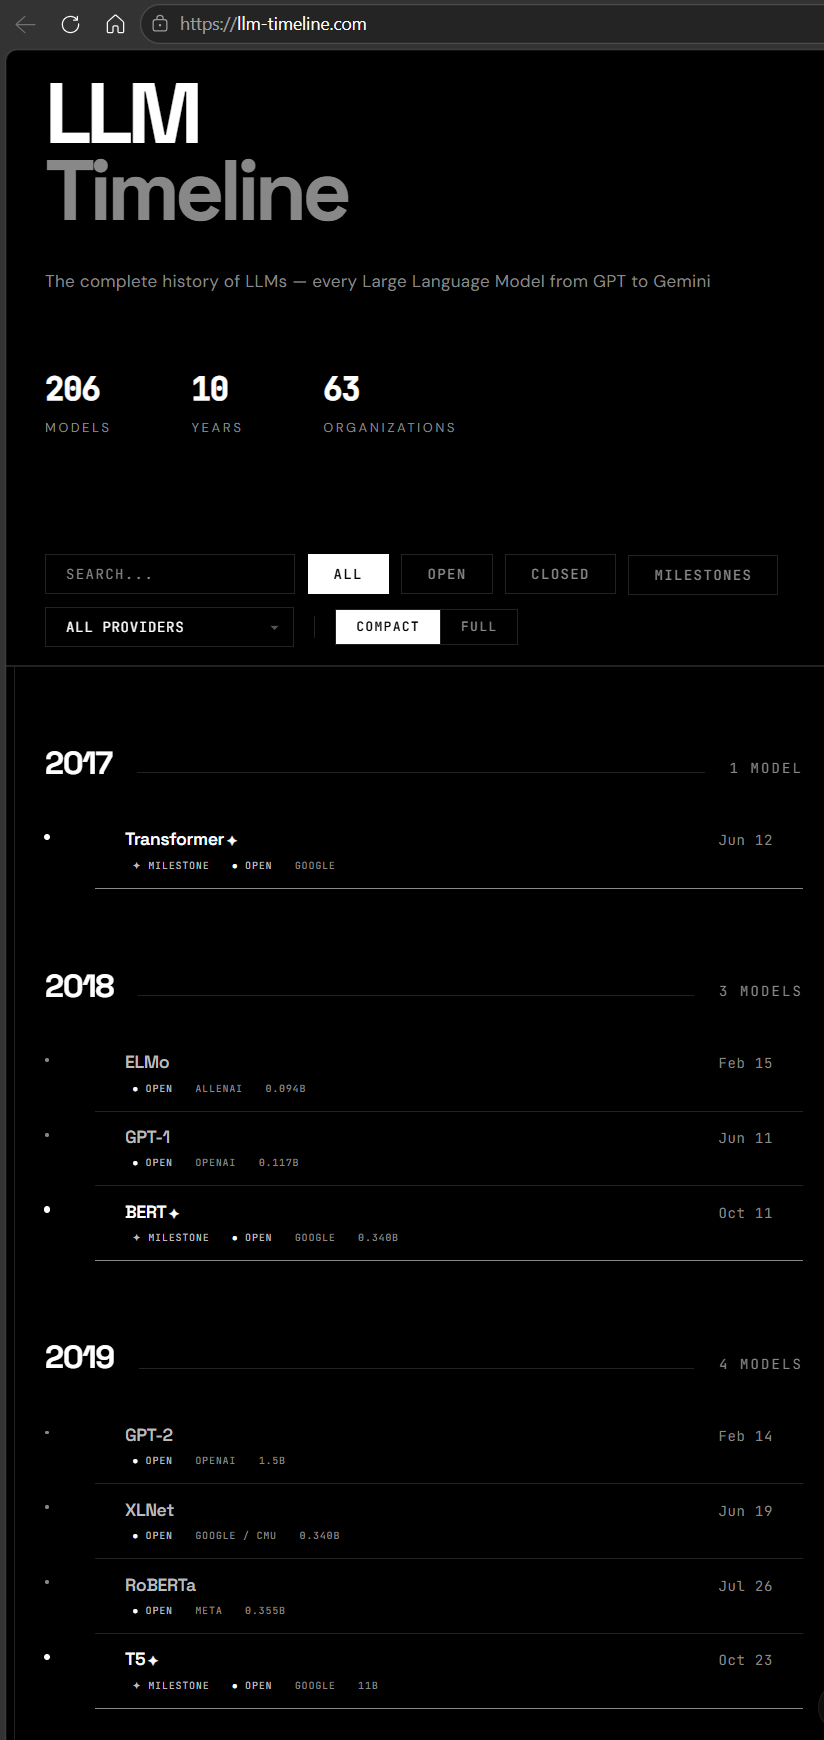
現在想盤點 LLM 模型的話,有個 LLM Timeline 專案收集了 10 年來 206 個 (數量會持續收錄增加) LLM 模型依時間軸排列,倒是可以一看。
Comments
Be the first to post a comment