.NET AI 應用練習 2 - 整合本地 Embedding 模型 (初識 ONNX)
 |  | 0 |  |
雖說現在寫程式有 AI,程式語言不一定要綁死開發者(或者該說使用者)本身的技能,但只要還需要「人」參與協作(包含 Code Review、修改及除錯),選開發者擅長的語言多半還是利多於弊。基於這個理念,這系列文章我會以 C# 開發者視角,整理 .NET 開發 AI 應用程式範例,打算留在這個航道上的同學可以參考。
微軟針對 AI 應用開發有提供了一系列 .NET 官方框架或程式庫(MAF/MEAI/ONNX... 還不認識的同學可看這篇:.NET 開發 AI 應用程式之新手指南),本系列也會以其為基礎出發。
要對文字內容進行向量搜索,第一步是將文字透過嵌入模型(Embedding Model)轉成高維向量,讓電腦能用數學距離判段文字的相似性,簡單說是將文字變成能代表其語意的一串數字(類似座標的概念),例如:將一段包含「蘋果」的文字依據上下文理解成可以吃的水果還是 iPhone 手機?
由於 Embedding 是向量搜索的基本程序,過去做過很多,但都是用 OpenAI API 完成,這篇會來試試地端 Embedding 模型。
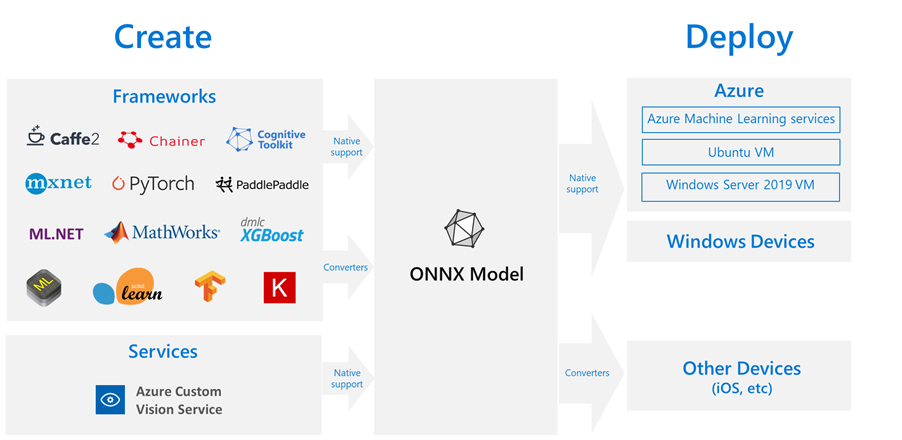
Python 是運作 AI 模型的主流,但若想在 .NET 專案整合 AI 模型,牽扯 Python/Docker 會增加複雜度,研究了一下,微軟、亞馬遜、Facebook 和 IBM 等共同推動的 ONNX (Open Neural Network Exchange) 算是 .NET 官方建議的解決方案。
ONNX 的概念是將訓練好的模型匯出或轉換成 ONNX 格式,透過 ONNX Runtime,模型便可在 Linux/macOS/Windows 等各種平台或裝置上執行。參考
下個問題是,如果文件以繁體中文為主,該選用哪個 Embedding 模型。參考 ihower 的評測結果,voyage、微軟的 multilingual-e5 系列與北京智源的 bge-m3 是值得優先考量的選擇。我用 .NET 實作,就選擇 multilingual-e5-large。
Multilingual E5 Text Embeddings是微軟研究院推出支援多國語言的 Embedding 模型。
| BEIR 評測 | # of layers | embedding dimension | Huggingface | |
|---|---|---|---|---|
| multilingual-e5-small | 46.6 | 12 | 384 | intfloat/multilingual-e5-small |
| multilingual-e5-base | 48.9 | 12 | 768 | intfloat/multilingual-e5-base |
| multilingual-e5-large | 51.4 | 24 | 1024 | intfloat/multilingual-e5-large |
| multilingual-e5-large-instruct | 52.5 | 24 | 1024 | intfloat/multilingual-e5-large-instruct |
模型可從 Huggingface 下載,但官方來源 intfloat 組織提供的 ONNX 版本 model_qint8_avx512_vnni.onnx 針對 AVX-512 及 VNNI 指令指最佳化,Xenova 有提供廣泛支援一般 CPU 的 ONNX INT8 量化模型 - model_quantized.onnx,較不用擔心因 CPU 支援性。
此外,E5 需配合 SenticePieceTokenizer 分詞器將字串轉成 Token (並針對 XLM-RoBERTa 編碼規則微調),執行時需下載 sentencepiece.bpe.model (大約 5MB)。
故文字轉為 E5 Embedding 的流程會是先取得分詞模型檔及模型 ONNX 檔,建立分詞器 SenticePieceTokenizer 及 InferenceSession,將文字轉成 Token 再使用模型推理轉為 Embedding 向量 (內含 Pooling 池化及 L2 Normalization 調整),之後便可對兩個 Embedding 進行餘弦相似計算預測相似度 (愈接近 1 愈相似,近 -1 表意思相反)。
值得一提的是,E5 模型屬於非對稱檢索(Asymmetric Retrieval),要求文字需加上 query: 或 passage: 前綴,供模型區別文字是「尋找解答的資訊需求」或是「提供事實的知識文本」以提供更精準的語意相似度匹配;至於要用在非問題應用,純粹比較多段文字的相似性,則可一律都加上 query:。
我做了一個送分題等級範例,共七題差異度很大的問答、七題簡答,測試在本機運行,使用 ONNX Runtime 跑 multilingual-e5-large 模型將文字轉為 Embedding 連連看,看能否正確地匹配問題及答案。
- query: 「山重水複疑無路,柳暗花明又一村」描寫了怎樣的心境與情境?
passage: 詩句出自陸游〈遊山西村〉,描寫山路曲折、景色變化,原以為前方無路,卻突然發現柳色深綠、花色明麗的村莊。除了描寫自然景觀,也表達詩人在困境中意外發現轉機的驚喜,後來常用來比喻事情看似陷入困境,卻可能出現新的希望。 - query: 臺灣西部平原為何成為人口與農業活動較密集的地區?
passage: 臺灣西部平原地勢平坦,河川沖積形成肥沃土壤,適合農業發展;同時交通建設與都市發展較早,工商業活動集中,就業機會較多。因此西部平原兼具適合居住的自然條件與較完善的交通、產業機能,人口密度通常高於東部地區。 - query: 試說明鄭成功為何於1661年率軍攻打臺灣,以及此行動的歷史影響。
passage: 鄭成功為延續反清復明事業,需要建立穩定的根據地。當時荷蘭人控制臺灣南部,鄭成功遂於1661年率軍攻臺,翌年荷蘭人投降,結束荷蘭在臺灣南部的統治。此後鄭氏政權以臺灣為基地經營,促進漢人移民與農業發展,也使臺灣成為明鄭政權的重要據點。 - query: 在民主政治中,為何需要保障新聞自由與言論自由?
passage: 新聞與言論自由能讓人民取得不同觀點與公共資訊,監督政府及其他權力機構,並參與公共議題討論。如果缺乏這些自由,政府施政可能較難受到社會檢驗,人民也可能無法充分表達意見。因此保障新聞與言論自由,是民主政治中促進公共討論與權力制衡的重要條件。 - query: 為什麼水在標準大氣壓下加熱至100°C時會沸騰?
passage: 水受熱時,分子運動加快,溫度逐漸升高。當水的飽和蒸氣壓等於外界大氣壓力時,液體內部便能形成大量氣泡並向外逸出,此現象稱為沸騰。在標準大氣壓下,水的飽和蒸氣壓約在100°C時等於大氣壓,因此水的沸點為100°C;若外界壓力改變,沸點也會改變。 - query: 為什麼植物的根、莖、葉各具有不同的構造與功能?
passage: 植物的不同器官具有分工。根主要負責固定植物並吸收水分與礦物質;莖負責支撐植物,並運輸水分與養分;葉則是進行光合作用的主要場所,可利用光能製造有機養分。不同構造與功能彼此配合,使植物能有效獲取資源、製造養分並維持生長。 - query: 「滄海桑田」這個成語比喻什麼意思?
passage: 指世事變化很大,常用來形容世間事物經歷長久時間後發生巨大的變化。 - query: 一個三角形的底為 8 公分,高為 5 公分,請問它的面積是多少?
passage: 三角形面積 = 底 × 高 ÷ 2 = 8 × 5 ÷ 2 = 20 平方公分。 - query: 世界上面積最大的洲是哪一洲?
passage: 亞洲(Asia)是世界上面積最大的洲。 - query: 秦始皇統一六國後,建立了中國歷史上第一個中央集權的統一帝國,這個帝國是哪一個?
passage: 秦朝。 - query: 在民主政治中,「人民透過投票選出代表來治理國家」主要屬於哪一種制度? passage: 代議民主制度。
- query: 水在標準大氣壓下的沸點是多少攝氏度?
passage: 水在標準大氣壓(1 atm)下的沸點是 100°C。 - query: 植物進行光合作用時,主要利用哪一種氣體,並釋放哪一種氣體?
passage: 植物主要吸收二氧化碳(CO₂),並釋放氧氣(O₂)。 - query: 地球大氣層中,主要吸收太陽紫外線、保護生物免受過量紫外線傷害的是哪一層?
passage: 臭氧層,主要位於平流層中。
以下說說 .NET 程式怎麼寫。
專案要引用 Microsoft.ML.OnnxRuntime 及 Microsoft.ML.Tokenizers 套件,開始執行前先由 Huggingface 下載 model_quantized.onnx 及 sentencepiece.bpe.model。接下來先將 sentencepiece.bpe.model 分詞資料傳給 SentencePieceTokenizer 建立分詞器將文字切成 Token ID 陣列(其中有個眉角是 multilingual-e5 使用 XLM-RoBERTa 的 SentencePiece 規格需要一些客製調整,我放在 long[] Encode(string text) 方法中),得到 long[],再來用 model_quantized.onnx 建立 ONNX InferenceSession,在 float[][] Embed(IReadOnlyList<string> texts) 中將多個字串批次轉成 Embedding 向量。由於 GPU 對於大量矩陣運算有優化加速設計,故建議一次傳入多個字串一次處理,取最長字串的長度展開成固定大小的二維陣列 long[][] 填入字元資料,再用 Attention Mask 標示哪些位置有值,將此陣列交給模型進行運算,此部分邏輯我放在 MultilingualE5Model.Embed() 中。
Program.cs 程式如下:
using System.Diagnostics;

const string ModelBaseUrl = "https://huggingface.co/Xenova/multilingual-e5-large/resolve/main";

string modelDirectory = Path.Combine(AppContext.BaseDirectory, "models", "multilingual-e5-large");
string modelPath = Path.Combine(modelDirectory, "model_quantized.onnx");
string tokenizerPath = Path.Combine(modelDirectory, "sentencepiece.bpe.model");

Directory.CreateDirectory(modelDirectory);


await DownloadHelper.DownloadIfMissingAsync($"{ModelBaseUrl}/onnx/model_quantized.onnx?download=true", modelPath);
await DownloadHelper.DownloadIfMissingAsync($"{ModelBaseUrl}/sentencepiece.bpe.model?download=true", tokenizerPath);

var lines = File.ReadAllLines("sample.txt");

var qa = new QASet();
List<QASet> faq = new List<QASet>();
foreach (var line in lines)
{
	if (line.StartsWith("query: "))
	{
		qa.Question = line;
	}
	else if (line.StartsWith("passage: "))
	{
		qa.Answer = line;
		faq.Add(qa);
		qa = new QASet();
	}
}
var texts = faq.SelectMany(f => new[] { f.Question, f.Answer }).ToArray();

Console.WriteLine("載入 ONNX 模型...");
using var tokenizer = new MultilingualE5Tokenizer(tokenizerPath);
using var model = new MultilingualE5Model(modelPath, tokenizer);

var stopwatch = Stopwatch.StartNew();
float[][] embeddings = model.Embed(texts);
stopwatch.Stop();

Console.WriteLine($"\n產生 {embeddings.Length} 筆、每筆 {embeddings[0].Length} 維的 Embedding,耗時 {stopwatch.ElapsedMilliseconds:N0} ms。");

// 將 Embedding 結果對映回每個 QASet
for (int i = 0; i < faq.Count; i++)
{
	faq[i].QuestionEmbedding = embeddings[i * 2];
	faq[i].AnswerEmbedding = embeddings[i * 2 + 1];
	faq[i].CosineSimilarities = new float[faq.Count];
}

// 計算每個 QASet 的問題與答案之間的餘弦相似度
for (int i = 0; i < faq.Count; i++)
{
	for (int j = 0; j < faq.Count; j++)
	{
		faq[i].CosineSimilarities[j] = MultilingualE5Model.CosineSimilarity(faq[i].QuestionEmbedding, faq[j].AnswerEmbedding);
	}
}

Console.WriteLine("\n每個 QASet 的問題與答案餘弦相似度比對結果:");
for (int i = 0; i < faq.Count; i++)
{
	// 找出與當前 QASet 最相似的前三名答案
	var top3MostSimilarAnswers = faq[i].CosineSimilarities
		.Select((similarity, index) => new { similarity, index })
		.OrderByDescending(x => x.similarity)
		.Take(3)
		.ToArray();
	Console.ForegroundColor = ConsoleColor.Yellow;
	Console.WriteLine("Q: " + faq[i].Question);
	Console.ResetColor();
	foreach (var item in top3MostSimilarAnswers)
	{
		if (i == item.index) Console.ForegroundColor = ConsoleColor.Green;
		else Console.ResetColor();
		Console.WriteLine($"A [{item.similarity:F4}]: {faq[item.index].Answer}");
	}
	Console.WriteLine();
}

public class QASet
{
	public string Question { get; set; }
	public string Answer { get; set; }
	public float[] QuestionEmbedding { get; set; }
	public float[] AnswerEmbedding { get; set; }
	public float[] CosineSimilarities { get; set; }
}
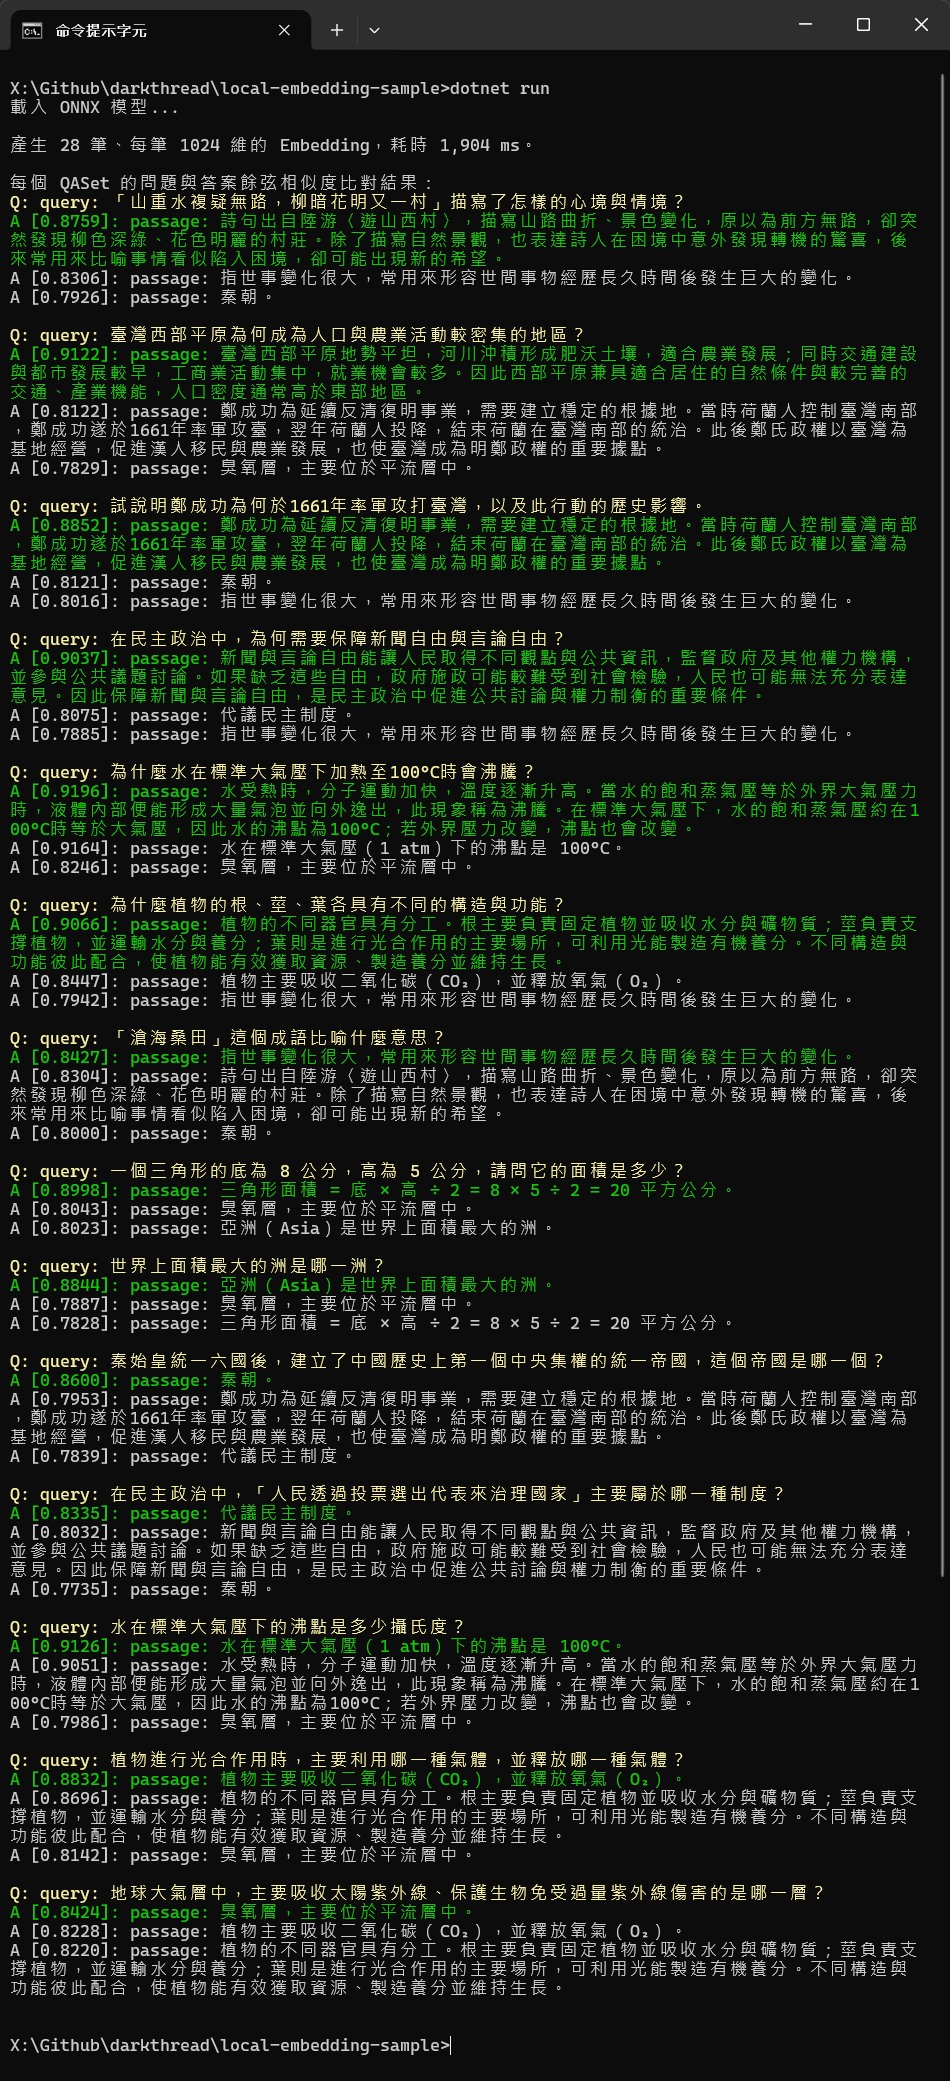
完整範例專案已放上 Github,有興趣研究的同學請自取。
This article demonstrates how C# developers can run Microsoft’s multilingual-e5-large embedding model locally using ONNX Runtime and SentencePieceTokenizer, generate Chinese text embeddings in batches, and match questions with answers through cosine similarity—without relying on Python, Docker, or cloud APIs.
Comments
Be the first to post a comment